โดย Insightist™ | เผยแพร่: 8 พ.ย 2569 | อ้างอิง: HuggingFace
สรุปสาระสำคัญ
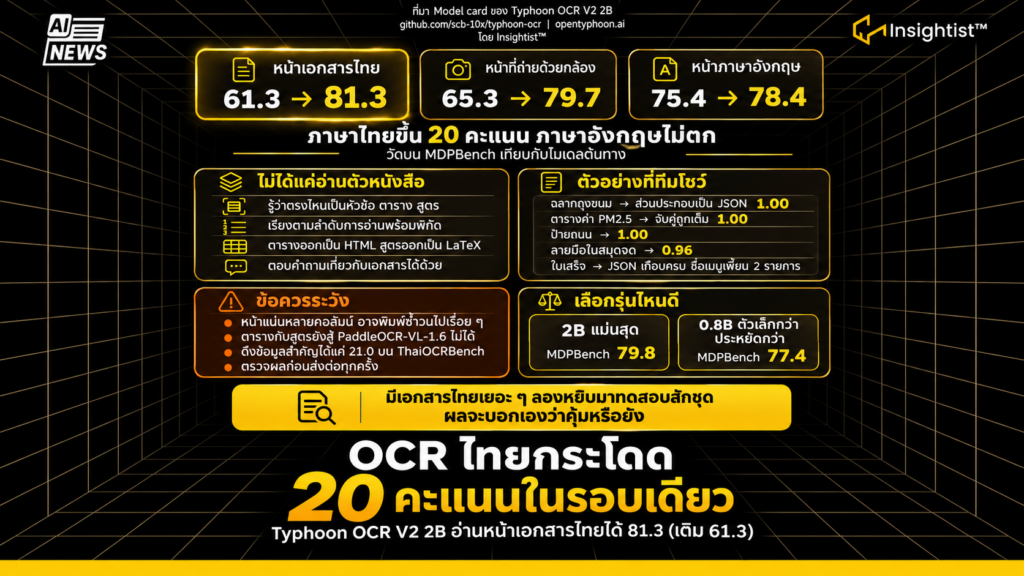
- Typhoon OCR V2 2B ปรับต่อจาก Infinity-Parser2-Flash คะแนนหน้าภาษาไทยบน MDPBench ขึ้นจาก 61.3 เป็น 81.3
- ภาษาอังกฤษไม่ตก ขึ้นจาก 75.4 เป็น 78.4 ส่วน OmniDocBench v1.6 ทรงตัวที่ 90.97 (ต้นทาง 91.03)
- ตอบคำถามเอกสาร ดึงข้อมูลเป็น JSON และอ่านลายมือได้ ThaiOCRBench ขึ้นจาก 40.5 เป็น 59.9
- ยังมีข้อจำกัดเรื่องพิมพ์ซ้ำวน ตาราง สูตร และการดึงข้อมูลสำคัญ ต้องตรวจผลก่อนใช้ต่อ
ถ้าคุณเคยนั่งพิมพ์ข้อมูลจากใบเสร็จทีละใบ เรื่องนี้กำลังมีทางลัดให้ลองครับ

Typhoon OCR V2 2B คือ อะไร และต่างจาก OCR ทั่วไปยังไง?
มัน คือ โมเดลอ่านเอกสารภาษาไทยและอังกฤษ ที่คืนผลเป็นองค์ประกอบของหน้า ทั้งหัวข้อ ข้อความ ตาราง สูตร (13 ประเภท) เรียงตามลำดับการอ่านพร้อมพิกัด ตารางออกเป็น HTML สูตรเป็น LaTeX รุ่นก่อนหน้าอย่าง Typhoon OCR 1.5 คืนแค่ Markdown ไม่มีตำแหน่ง
อ่านภาษาไทยแม่นขึ้นแค่ไหน?
บน MDPBench หน้าภาษาไทยได้ 81.3 สูงสุดในกลุ่มที่ทีมทดสอบเอง ทีมระบุว่ารันทุกโมเดลเองด้วยสคริปต์ชุดเดียวกันโมเดลที่เทียบ มีดังนี้
- Typhoon OCR V2 2B — 81.3
- dots.mocr 3B — 73.6
- Chandra-OCR-2 5B — 71.1
- PaddleOCR-VL-1.6 0.9B — 68.4
- Infinity-Parser2-Flash 2B — 61.3
ฝั่งหน้าที่ถ่ายด้วยกล้อง ขึ้นจาก 65.3 เป็น 79.7 เทียบกับโมเดลต้นทาง
Typhoon OCR V2 มี 2 รุ่น คือ รุ่น 2B & 0.8B
| หัวข้อ | 2B | 0.8B |
|---|---|---|
| ขนาด | 2B | 0.8B (หน้า Hub แสดง 0.9B) |
| โมเดลต้นทาง | Infinity-Parser2-Flash | ATH-MaaS/OvisOCR2 (สร้างบน Qwen3.5-0.8B) |
| สถาปัตยกรรม | Qwen3.5 | Qwen3.5 |
| วิธีเทรน | SFT แล้วต่อด้วย GRPO | SFT แล้วต่อด้วย GRPO |
| MDPBench รวม | 79.8 | 77.4 |
| MDPBench หน้าไทย | 81.3 | 77.2 |
| MDPBench หน้าถ่ายด้วยกล้อง | 79.7 | 75.9 |
| olmOCR-bench | 84.7 | 81.7 |
| ThaiOCRBench | 59.9 | 36.4 |
| SEA-DocBench NED (ยิ่งต่ำยิ่งดี) | 0.1153 | 0.1081 |
| OmniDocBench v1.6 | 90.97 | 89.37 |
เอาไปทำอะไรได้กับงานเอกสาร?
ทีมโชว์ตัวอย่างไว้ 3 แบบ ดึงเปอร์เซ็นต์ส่วนประกอบจากฉลากถุงขนม (ได้ 1.00) ดึงทุกช่องจากใบเสร็จร้านอาหารเป็น JSON (ผิดแค่ชื่อเมนูสะกดเพี้ยนสองรายการ) และอ่านลายมือในสมุดจด (ได้ 0.96) งานเหล่านี้ใช้การถามด้วยภาษาธรรมดาได้เลย
มีอะไรที่ต้องระวังก่อนลงมือ?
ทีมเปิดเผยข้อจำกัดเอง หน้าแน่นหลายคอลัมน์เสี่ยงพิมพ์ซ้ำวน ตารางกับสูตรสู้ PaddleOCR-VL-1.6 ไม่ได้ (table TEDS 82.94 เทียบ 93.38) งานดึงข้อมูลสำคัญได้ 21.0 บน ThaiOCRBench และผลขึ้นกับเวอร์ชัน vLLM ต้องใช้ 0.33.0 ขึ้นไป หรือเปิดโหมด eager บนเวอร์ชันเก่า
- เอกสารไทยที่ต้องแม่นสุด ภาพถ่าย ลายมือ หรืออยากถามตอบ/ดึงข้อมูลเป็น JSON เลือก 2B
- แค่แปลงหน้าเอกสารเป็นข้อความกับ layout จำนวนมาก และอยากประหยัดทรัพยากร ลอง 0.8B ก่อน แล้วเทียบกับเอกสารจริง
คำถามที่พบบ่อย (FAQs)
Q: รองรับภาษาอะไรบ้าง
A: ไทยกับอังกฤษ ภาษาจีนอยู่ในข้อมูลเทรนแต่ทีมยังไม่ได้ประเมินแยก ภาษาอื่นยังไม่ได้ทดสอบ
Q: ตอบคำถามเกี่ยวกับเอกสารได้ไหม
A: ได้ ส่งคำถามเป็นข้อความแทน prompt ปกติ คำตอบกลับมาเป็นข้อความธรรมดา
Q: มีรุ่นเล็กกว่าไหม
A: มี Typhoon OCR V2 0.8B ได้ MDPBench 77.4 และหน้าไทย 77.2
Q: ใช้ผ่านเครื่องมืออะไรได้
A: vLLM กับ Transformers ที่ทีมทดสอบแล้ว ส่วน SGLang, llama.cpp, Ollama ยังไม่ได้ทดสอบ
ถ้าคุณสนใจข่าวสารนี้ ให้ Add Line OA เพิ่ม: https://lin.ee/ulsmCKk หรือ