โดย Insightist™ | เผยแพร่: 25 ตุลาคม 2569 | อ้างอิง: Kimi Blog
สรุปสาระสำคัญ
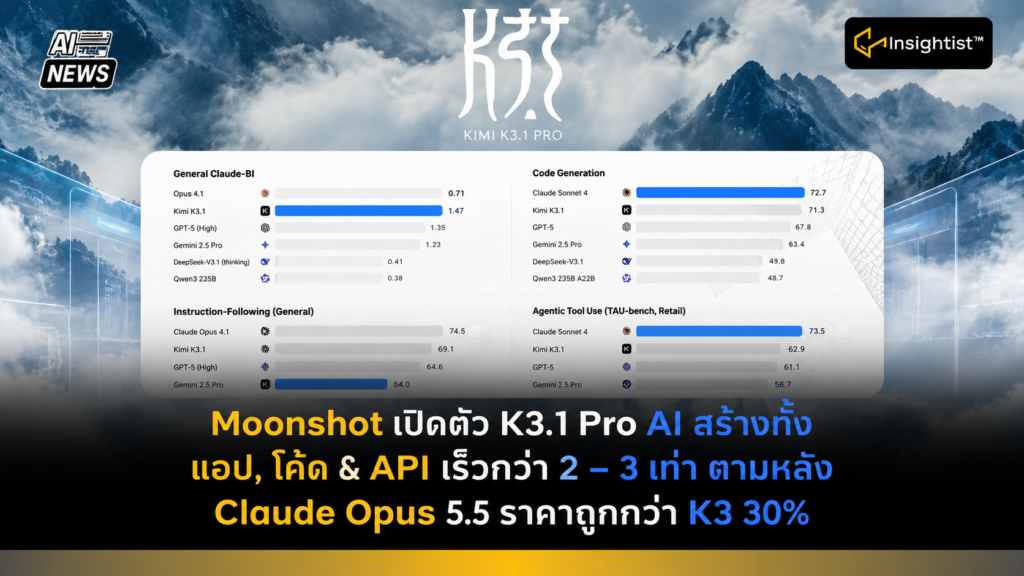
- Terminal-Bench 4.0 ได้ 65.7% ตามหลัง Claude Opus 5.5 (66.4%) นำ GPT-6 Astra (58.2%)
- อัตราหลอนระดับ claim บนชุดทดสอบยากลดจาก 23.4% เหลือ 8.3%
- ใช้ได้แล้วที่ Kimi.ai, Kimi Work, Kimi Code และ Kimi API
- น้ำหนักโมเดลเต็มจะเปิดให้โหลดภายใน 4 พ.ย. 2026
คะแนนโค้ดต่างกัน 0.7 จุดระหว่างโมเดลปิดของแบรนด์ใหญ่ กับโมเดลที่กำลังจะเปิดน้ำหนักให้คนโหลดไปรันเอง ตัวเลขนี้ทำให้ทีมที่เคยเลือกโมเดลจากไม่กี่เจ้า ต้องกลับมาเปิดตารางเทียบอีกรอบ
Kimi K3.1 Pro เก่งเรื่องเขียนโค้ดแค่ไหน
เก่งใกล้โมเดลแนวหน้ามาก บน Terminal-Bench 4.0 ที่ทดสอบ Coding Agent ด้วยงาน Terminal จริงแบบมีข้อจำกัดทรัพยากร คะแนนเรียงแบบนี้
- Claude Opus 5.5 ได้ 66.4%
- Kimi K3.1 Pro ได้ 65.7%
- GPT-6 Astra ได้ 58.2%
ส่วน Kimi Code Bench 3.0 Long-horizon ซึ่งเป็นข้อสอบภายในของ Kimi เอง K3.1 Pro ได้ 61.2% เทียบกับ K3 รุ่นก่อนที่ได้ 55.95%
ทำอะไรได้อีกนอกจากเขียนโค้ด
ได้งาน 3D และงานการเงินด้วย บน BenchCAD ที่ให้สร้างโมเดล 3D จากภาพหลายมุม K3.1 Pro ได้ 92.7% เมื่อใช้ tool เทียบกับ Claude Opus 5.5 ที่ 96.2% และ GPT-6 Astra ที่ 95.9% ฝั่งการเงิน OfficeQA Pro v2 ที่ให้วิเคราะห์ข้อมูลจากเอกสารการเงินจริง K3.1 Pro ได้ 64.4 สูงสุดในกลุ่มที่ Kimi นำมาเทียบ ข้อสอบภายในอย่าง Financial Modeling ดีขึ้น 7.2 คะแนนจาก K3 และ Business Operation ทำได้ราว 4.2 เท่าของ K3
ยังมีตัวอย่างงานยาว Kimi ให้ K3.1 Pro สร้างตัวจำลองการเดินของมนุษย์บนโมเดลกายวิภาคที่มีชิ้นส่วนโครงกระดูก 296 ชิ้นและกล้ามเนื้อ 402 ชิ้น ผ่าน 167 ภารกิจ จากที่ล้มภายในไม่กี่วินาที กลายเป็นเดินต่อเนื่อง 11.2 วินาที
หลอนน้อยลงจริงไหม
ลดลงในชุดทดสอบที่ยากที่สุดของ Kimi อัตรา hallucination ระดับ claim บน Kimi Hallu Bench Hard ลดจาก 23.4% เหลือ 8.3% และสัดส่วนคำตอบที่มีข้อเท็จจริงผิดอย่างน้อยหนึ่งจุด เหลือ 42.4% ของรุ่นก่อน Kimi ย้ำเองว่านี่คือ stress test ที่ตั้งใจให้โมเดลพลาด ตัวเลขไม่ใช่อัตราผิดพลาดตอนใช้จริงทั่วไป
จุดไหนที่ยังตามหลัง
มีหลายข้อ ProgramBench ที่วัดการสร้างโปรแกรมให้ผ่านเกณฑ์ ≥95% K3.1 Pro ได้ 31.5 ขณะที่ Claude Opus 5.5 ได้ 65.0 Terminal-Bench Science 0.1 ได้ 38.1 ส่วน GPT-6 Astra ได้ 68.1 ด้านไซเบอร์ Kimi ลบข้อมูลที่เกี่ยวข้องออกจากการเทรนทั้งขั้น mid-training และ RL คะแนน xdev-bench-hard จึงอยู่ที่ 81.0% จากที่เคยได้ 90.5% ถ้าไม่ลบ และ Kimi บอกว่าความสามารถด้านนี้ยังตามหลังโมเดล proprietary แนวหน้าที่เปิดให้ใช้มาแล้วอย่างน้อยสามเดือน
ธุรกิจไทยทำอะไรได้ตอนนี้
ถ้าองค์กรไทยเจอปัญหาเรื่องส่งข้อมูลขึ้น API ต่างประเทศ โมเดลที่เปิดน้ำหนักและรันบนระบบตัวเองได้ เป็นอีกทางเลือกที่ควรเอาไปคุยกับทีมกฎหมายและ IT แต่ยังต้องรอดูเงื่อนไขการใช้ตอนปล่อยน้ำหนักจริง ระหว่างนี้เปิด Kimi Code แล้วเลือก K3.1 Pro ด้วยคำสั่ง /model เอางานที่ทำซ้ำบ่อยในบริษัทมาลองสัก 1 งาน เทียบกับโมเดลที่ใช้อยู่ ก่อนวันที่ 4 พ.ย.
คำถามที่พบบ่อย (FAQs)
Q: ใช้ Kimi K3.1 Pro ได้ที่ไหนบ้าง
A: ที่ Kimi.ai แอปมือถือ Kimi, Kimi Work (เวอร์ชัน 3.1.0 ขึ้นไป บน Windows และ Mac ชิป Apple silicon), Kimi Code และ Kimi API โดยเรียกชื่อ kimi-k3.1-pro หรือ kimi-k3.1-pro-highspeed
Q: รุ่น Highspeed ต่างกันยังไง
A: เร็วกว่า K3.1 Pro 2 ถึง 3 เท่า เหมาะกับงานที่ต้องการให้ตอบโต้ลื่น
Q: ต้องรอ 4 พ.ย. ไหมถึงจะเริ่มใช้ได้
A: ไม่ต้อง ใช้ผ่านแอปและ API ได้แล้ววันนี้ รอถึงวันที่ 4 พ.ย. 2026 เฉพาะน้ำหนักโมเดลเต็มที่จะเปิดให้โหลด
Q: องค์กรเปิดใช้ได้เลยไหม
A: ผู้ดูแลระบบ Kimi Enterprise ต้องเปิดเอง เพราะช่วงเปิดตัวตั้งค่าเริ่มต้นไว้เป็นปิด
Q: ตัวเลขทั้งหมดเชื่อได้แค่ไหน
A: ตัวเลขมาจากประกาศของ Kimi เอง และบางข้อสอบเป็นข้อสอบภายใน ควรรอผลทดสอบจากแหล่งอิสระก่อนตัดสินใจเรื่องใหญ่
ถ้าคุณสนใจข่าวสารนี้ ให้ Add Line OA เพิ่ม: https://lin.ee/ulsmCKk หรือ @nhx2358e