เคยไหมครับ… ที่อยากทำคอนเทนต์/แอนิเมชัน/ตัวละครเคลื่อนไหว แต่ติดที่ทำ motion มันใช้เวลา ใช้คน และใช้ทักษะสูงมาก
ไม่ว่าจะเป็นการทำเองในโปรแกรม หรือใช้ MoCap
สุดท้ายก็วนกลับมาที่คำเดิม… ต้นทุน และ เวลา
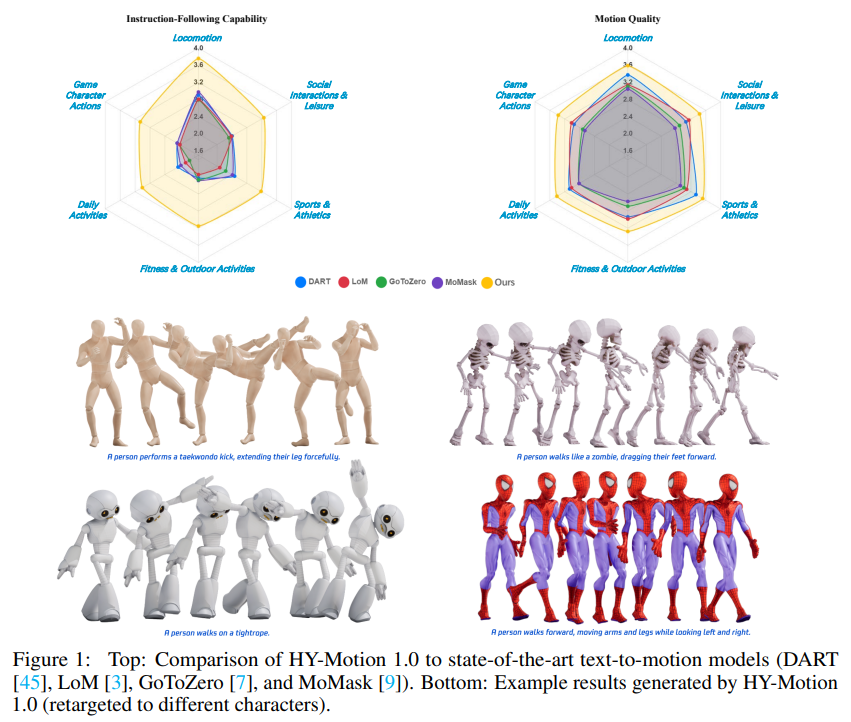
29 ธันวาคม 2568 Hunyuan เปิดตัว Hunyuan Motion 1.0 AI ตัวนึงที่กำลังทำให้การสร้างการเคลื่อนไหวมนุษย์แบบ 3D เข้าใกล้คำว่า สร้าง Motion ด้วยวิธีที่ง่ายขึ้น ซึ่งเป็นชุดโมเดลสำหรับ Text-to-Motion Generation คือ พิมพ์คำบรรยายท่า → ได้การเคลื่อนไหวมนุษย์แบบ 3D
จุดเด่น คือ สเกลโมเดลใหญ่ขึ้นมาก และทำให้ instruction-following (อ่านคำสั่งแล้วทำตามได้ตรงกว่าเดิม) ดีขึ้น พร้อมคุณภาพท่าทางที่ดูสมจริงกว่าโมเดล Open-Source ที่มีอยู่
Framework ทำงานยังไง
- แบ่งเป็น 2 ช่วงใหญ่ ๆ คือ Data Framework และ Model + Training Framework
- Data Framework: ทำไมโมเดลนี้ถึง ดูสมจริงขึ้น
- ก่อนจะเก่งได้ ต้องมีข้อมูลที่ดี ก่อน สิ่งที่ทีม Tencent ทำคือ รวม data จากหลายแหล่ง แล้วจัดระเบียบใหม่ให้เป็นมาตรฐานเดียวกัน เช่น
- in-the-wild human motion videos
- Motion capture data (MoCap)
- 3D animation assets
- แล้วจัดเรียง เช่น
- ท่าซ้ำ ๆ
- ท่าที่เพี้ยน/ผิดธรรมชาติ
- Artifact อย่าง foot sliding
- จากนั้นค่อยทำ motion captioning = ทำคำบรรยายให้ motion โดยใช้ vision-language models (VLMs) ช่วย และบางส่วนมี human verification มาช่วยตรวจคุณภาพ
- ก่อนจะเก่งได้ ต้องมีข้อมูลที่ดี ก่อน สิ่งที่ทีม Tencent ทำคือ รวม data จากหลายแหล่ง แล้วจัดระเบียบใหม่ให้เป็นมาตรฐานเดียวกัน เช่น
- Model Framework: ตัวหลัก
- แกนหลัก คือ โมเดลแนว Diffusion Transformer (DiT) ที่เทรนด้วย flow matching คือ ตอนสร้าง motion มันเริ่มจาก Noise แล้วค่อย ๆ เปลี่ยน Noise ให้กลายเป็น Motion ที่เป็นท่าจริง เหมือนปั้นดินจากก้อนมั่ว ๆ ให้เป็นท่าที่เราสั่ง เพื่อให้ Prompt ไปคุม motion ได้แน่น
- ตัว Motion ที่ทำตาม Prompt ได้ดีขึ้นจาก Hunyuan Motion 1.0 มาจาก
- 1. ถูกเทรนบนข้อมูลมหาศาล → ให้โมเดลรู้จักโลกของ Motion ก่อน
- 2. จากนั้นเทรนต่อบนข้อมูลที่คัดคุณภาพสูง → ขัดให้ motion เนียนขึ้น สมจริงขึ้น
- 3. เก็บงานให้ถูกใจคนดู โดยแบ่งเป็น 2 Phase
- 1. DPO: ให้ Human Judges เลือก winner/loser จากคู่ตัวอย่างจำนวนมาก แล้วปรับให้โมเดลเอนเอียงไปทางผลลัพธ์ที่คนชอบและทำตามคำสั่งได้ตรง
- 2. Flow-GRPO: ใส่ Reward ที่ชัดเจนขึ้น 2 ส่วน
- 1. Semantic Reward คือ Prompt สั่งอะไร โมเดลทำตรงนั้นไหม? และ Motion นี้เข้ากับข้อความแค่ไหน?
- ถ้าข้อความกับ motion เข้าคู่กัน → ได้คะแนน semantic สูง
- ถ้าไม่เข้าคู่ → คะแนนตก
- 2. Physical Reward เช็คว่า ท่าดูสมจริงไหม โดยลงโทษ Artifact หมายความว่า ถึงจะทำตามคำสั่งของ Prompt ถูก แต่ถ้าท่าดูแปลก ๆ หลอกตา คนดูยังรู้สึกไม่จริงอยู่ดี
- 1. Semantic Reward คือ Prompt สั่งอะไร โมเดลทำตรงนั้นไหม? และ Motion นี้เข้ากับข้อความแค่ไหน?
- Artifact คือ ความผิดปกติ/อาการแปลก ๆ ใน motion
- ถ้า Motion สร้างได้ไว + ทำตาม Prompt ได้ตรงขึ้นจริง แปลว่าอนาคตเราจะทำสิ่งพวกนี้ได้ง่ายขึ้น:
- ทำ Character Content แบบเร็วขึ้น
- ทำ Animation Prototype สำหรับเกม/คอนเซ็ปต์
- ทำสื่อการสอน/สาธิตท่าทาง
- ทำ Motion สำหรับ Virtual Presenter / Avatar
ข้อสรุป:
Hunyuan Motion 1.0 AI ที่พยายามยกระดับ text-to-motion ด้วยสูตร 3 อย่าง:
- Data เยอะและหลากหลาย
- Data คุณภาพสูงที่คัดและ Caption ดี
- Training 3 Stages + Reinforcement Learning เพื่อให้ตรงคำสั่ง + ดูสมจริง
Source:
Tencent Hunyuan, X (Tencent HY), HuggingFace, Demo, Arxiv, Github